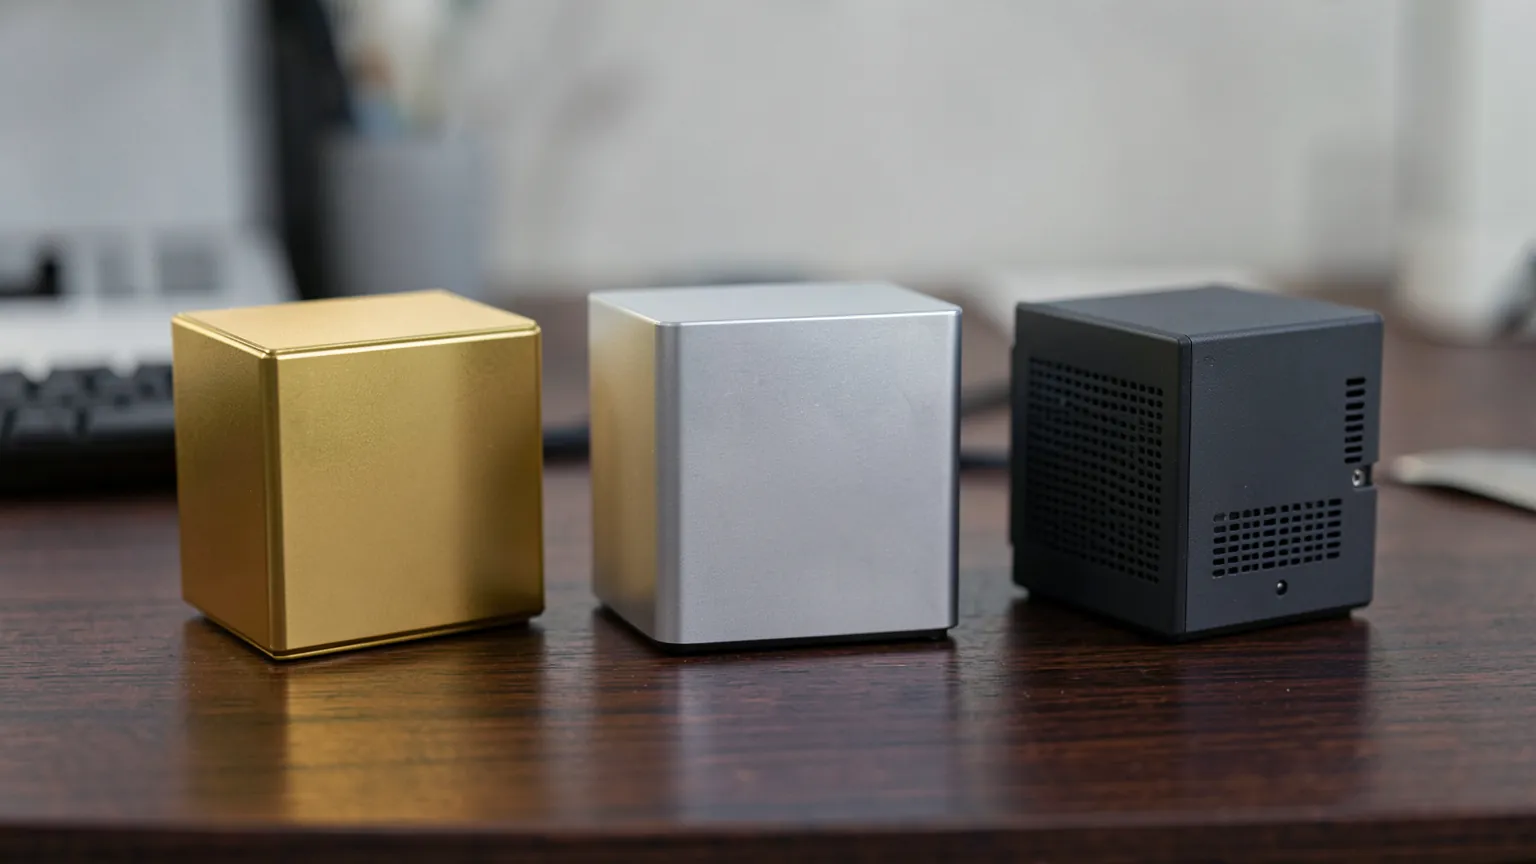
NVIDIA DGX Spark, Mac Studio con M5 Ultra o MINISFORUM MS-S1 MAX: las tres máquinas que hoy se compran para ejecutar IA en local se parecen en la foto (cajas pequeñas, silenciosas, con más de 100 GB de memoria para los modelos) y se parecen muy poco en lo que hacen bien. Una es la puerta de entrada al ecosistema de NVIDIA, otra es la que genera texto más rápido con modelos enormes y la tercera es, con diferencia, la más barata. Esta comparativa explica en qué se diferencian de verdad, con cifras oficiales, y cuál tiene sentido para cada tipo de uso.
La respuesta corta: cuál comprar
- Si desarrollas o haces ajuste fino con PyTorch y CUDA: DGX Spark. Es el mismo software que corre en los centros de datos de NVIDIA y lo que funciona en tu mesa funciona luego en la nube.
- Si quieres la máxima velocidad con modelos muy grandes y no dependes de CUDA: Mac Studio con M5 Ultra. Su ancho de banda de memoria es más de cuatro veces el del Spark.
- Si quieres ejecutar modelos grandes gastando lo mínimo: MINISFORUM MS-S1 MAX. Tiene los mismos 128 GB que el Spark por bastante menos dinero, con Windows o Linux y sin ecosistema cerrado.
- Si tus modelos caben en 32 GB: ninguna de las tres. Una RTX 5090 en un PC normal es más rápida que todas.
Y una advertencia honesta antes de seguir: si lo que buscas es simplemente el mejor modelo posible para programar o escribir, y no te preocupa que tus datos salgan de casa, ninguna de estas máquinas iguala a los modelos de la nube de Anthropic, OpenAI o Google, que además se pagan por uso. Una máquina de IA local se compra por privacidad, por coste a largo plazo cuando el uso es intensivo, por trabajar sin conexión o por aprender y experimentar con modelos abiertos. Si ninguna de esas razones es la tuya, la suscripción sale más a cuenta.
El resto del artículo explica cada recomendación en detalle. Si todavía no tienes claro qué modelo quieres mover, empieza por nuestra guía de modelos de IA local según la memoria disponible: esa decisión va antes que la del hardware.
Especificaciones frente a frente
| Característica | NVIDIA DGX Spark | Mac Studio M5 Ultra | Mac Studio M5 Max | MINISFORUM MS-S1 MAX |
|---|---|---|---|---|
| Chip | GB10 Grace Blackwell | Apple M5 Ultra | Apple M5 Max | AMD Ryzen AI Max+ 395 |
| CPU | 20 núcleos Arm | Hasta 36 núcleos | 18 núcleos | 16 núcleos Zen 5 |
| GPU | Blackwell, 6.144 núcleos CUDA | Hasta 80 núcleos | Hasta 40 núcleos | Radeon 8060S integrada |
| Memoria máxima | 128 GB LPDDR5X | 512 GB | 128 GB | 128 GB LPDDR5X-8000 |
| Ancho de banda | 273 GB/s | 1,2 TB/s | 614 GB/s | 256 GB/s |
| Rendimiento IA declarado | 1 petaFLOP en FP4 | 4,3 veces el M3 Ultra | Neural Accelerators en cada núcleo | 126 TOPS la plataforma |
| Sistema | DGX OS (Ubuntu) | macOS | macOS | Windows 11 o Linux |
| Software de IA | CUDA, PyTorch, todo el stack de NVIDIA | MLX, llama.cpp, Ollama | MLX, llama.cpp, Ollama | ROCm, Vulkan, llama.cpp, Ollama |
| Precio oficial de partida | 4.699 $ (desde febrero de 2026) | 5.499 $ | 2.499 $ | Según configuración |
Los precios son los oficiales de lanzamiento en Estados Unidos que publican los fabricantes. En España los tres se venden bastante más caros por los impuestos y, en el caso del Spark, por la reventa, como explicamos al final.
El dato que decide la velocidad: el ancho de banda
Aquí está la clave que casi ninguna ficha comercial explica. Cuando un modelo de lenguaje genera texto, para cada token que escribe tiene que leer todos sus pesos de la memoria. Un modelo de 70.000 millones de parámetros cuantizado a 4 bits ocupa unos 40 GB: para cada palabra, la máquina mueve 40 GB. Por eso la velocidad de generación depende, sobre todo, de cuántos gigas por segundo puede leer la memoria, no de cuántos TOPS o petaFLOPS anuncia el chip.
Ancho de banda de memoria: lo que marca los tokens por segundo
Al generar texto, un modelo lee todos sus pesos por cada token. Cuanto más ancho de banda, más rápido escribe.
Ver los datos en tabla
| Dato | Ancho de banda |
|---|---|
| Mac Studio M5 Ultra | 1 200 GB/s |
| Mac Studio M5 Max | 614 GB/s |
| NVIDIA DGX Spark | 273 GB/s |
| MINISFORUM MS-S1 MAX | 256 GB/s |
| Referencia: RTX 5090 (32 GB) | 1 792 GB/s |
Con el ancho de banda se puede calcular el techo teórico de cada máquina: basta con dividir los GB/s entre lo que ocupa el modelo. No es un benchmark (en la práctica siempre se queda por debajo, entre un 60 % y un 80 % de ese techo), pero ordena las máquinas con mucha fiabilidad:
| Modelo (cuantizado a 4 bits) | Ocupa | DGX Spark | M5 Ultra | M5 Max | MS-S1 MAX |
|---|---|---|---|---|---|
| Modelo denso de 8B | ~5 GB | ~55 tok/s | ~240 tok/s | ~120 tok/s | ~51 tok/s |
| Modelo denso de 32B | ~20 GB | ~14 tok/s | ~60 tok/s | ~31 tok/s | ~13 tok/s |
| Modelo denso de 70B | ~40 GB | ~7 tok/s | ~30 tok/s | ~15 tok/s | ~6 tok/s |
Techo teórico calculado como ancho de banda entre tamaño del modelo. Los modelos de mezcla de expertos (MoE), como gpt-oss, Qwen 3.5 de 35B o los grandes de DeepSeek, solo leen los expertos activos en cada token y van mucho más rápido que un denso del mismo tamaño total: es la razón por la que estas máquinas se llevan tan bien con ellos.
La conclusión es clara: en generación de texto, el DGX Spark y el MS-S1 MAX juegan en la misma liga, porque tienen un ancho de banda casi idéntico, y el Mac Studio M5 Ultra está en otra.
Donde el Spark sí gana: el procesado del prompt
Hay otra fase que los números de arriba no recogen: el procesado del prompt (lo que en inglés se llama prefill). Cuando le pasas al modelo un documento de 50 páginas, antes de escribir la primera palabra tiene que procesarlo entero, y eso sí depende de la potencia de cálculo. Ahí los Tensor Cores de Blackwell del Spark, con su petaFLOP en FP4, sacan ventaja clara sobre la gráfica integrada de AMD. Si tu trabajo es resumir documentos largos o hacer RAG con mucho contexto, la diferencia entre el Spark y el MS-S1 MAX es mayor de lo que sugiere el gráfico.
El dato que decide qué modelos caben: la memoria
El ancho de banda dice lo rápido que va. La memoria dice qué puedes ejecutar. Y aquí la diferencia entre las tres cajas y un PC con gráfica es enorme.
Memoria máxima que puede usar el modelo
Decide qué modelos caben. Un 70B en Q4 ocupa unos 40 GB; un MoE de 235B, más de 130 GB.
Ver los datos en tabla
| Dato | Memoria unificada o VRAM |
|---|---|
| Mac Studio M5 Ultra | 512 GB |
| Mac Studio M5 Max | 128 GB |
| NVIDIA DGX Spark | 128 GB |
| MINISFORUM MS-S1 MAX | 128 GB |
| Referencia: RTX 5090 | 32 GB |
- Con 128 GB (Spark, M5 Max y MS-S1 MAX) caben con holgura los modelos densos de 70B y los MoE de más de 100.000 millones de parámetros cuantizados, como gpt-oss de 120B. Es el punto dulce de 2026.
- Con 512 GB (solo el M5 Ultra en su configuración máxima) caben modelos MoE de 400.000 millones de parámetros o más, que hasta ahora exigían un servidor.
- Con 32 GB (la RTX 5090) el límite está en modelos de unos 30B; un 70B solo funciona repartiendo capas con la RAM, y la velocidad se desploma.
Un matiz sobre el MINISFORUM: en Windows se pueden asignar como máximo 96 GB a la gráfica, así que no todos los 128 GB están disponibles para el modelo. En Linux se puede asignar más. En los Mac y en el Spark la memoria es unificada y el sistema la reparte según haga falta.
NVIDIA DGX Spark: para quien vive en CUDA
El DGX Spark no es la máquina más rápida de esta comparativa en generación de texto, y NVIDIA tampoco la vende así. Su argumento es otro: es un DGX en pequeño. Lleva DGX OS, el mismo stack de software que los servidores de NVIDIA, y todo lo que desarrollas en él (un ajuste fino con PyTorch, un servicio con vLLM o TensorRT-LLM, un agente con NIM) se despliega luego en la nube sin cambiar una línea.
Puntos fuertes
- CUDA nativo. Cualquier repositorio de IA de GitHub funciona a la primera; con AMD y Apple, no siempre.
- Ajuste fino y entrenamiento. Es donde más brilla: los Tensor Cores de quinta generación y el soporte de FP4 lo hacen muy superior a las otras dos para entrenar.
- Procesado de prompts largos, por la potencia de cálculo.
- Se pueden unir dos unidades por red de alta velocidad para trabajar con modelos que no caben en una.
Puntos débiles
- Ancho de banda de 273 GB/s: genera texto al ritmo del MS-S1 MAX, que cuesta bastante menos.
- Precio en alza. NVIDIA lo subió de 3.999 a 4.699 dólares en febrero por el coste de la memoria LPDDR5X, en plena crisis de precios de la RAM.
- No es un PC de uso general. Es Linux sobre Arm: nada de juegos ni de software de Windows.
Lo analizamos a fondo, incluidos sus problemas térmicos de las primeras unidades, en la review completa del NVIDIA DGX Spark.
Mac Studio M5 Ultra y M5 Max: la velocidad de generación
Apple presentó el nuevo Mac Studio en agosto y empezó a enviarlo el 22 de septiembre. Para IA local, el cambio importante está en el M5 Ultra: 1,2 TB/s de ancho de banda, un 50 % más que el M3 Ultra, hasta 512 GB de memoria unificada y, por primera vez en un chip Ultra, Neural Accelerators en la GPU. Apple habla de hasta 4,3 veces el rendimiento pico en IA del M3 Ultra.
Puntos fuertes
- El ancho de banda más alto de los tres, con diferencia: genera texto con modelos de 70B a una velocidad cómoda para conversar.
- Hasta 512 GB, el único que mueve modelos MoE gigantes en una sola caja.
- Silencio y consumo bajo, y un ordenador completo para todo lo demás.
- Clúster por Thunderbolt 5 con RDMA: varios Mac Studio pueden trabajar juntos.
Puntos débiles
- Sin CUDA. MLX y llama.cpp funcionan muy bien, pero parte del software de investigación no está disponible o llega tarde.
- El precio escala rápido con la memoria: la configuración de 512 GB llega a finales de octubre y Apple aún no ha publicado su precio.
- Entrenamiento más lento que en CUDA, aunque viable con MLX.
El M5 Max merece una mención aparte: con 614 GB/s y hasta 128 GB, duplica el ancho de banda del Spark y del MS-S1 MAX con la misma memoria, por un precio de partida inferior al del Spark. Para quien solo quiere inferencia rápida y no necesita CUDA, es probablemente la compra más equilibrada de esta comparativa. Tienes más detalle en nuestra review del Mac Studio M5 Ultra para desarrollo con IA local.
MINISFORUM MS-S1 MAX: la opción sensata
El MS-S1 MAX usa el Ryzen AI Max+ 395 de AMD, el chip que popularizó la idea de un mini PC con 128 GB de memoria compartida entre CPU y gráfica. Su ancho de banda, 256 GB/s, es prácticamente el del DGX Spark, así que en generación de texto rinde en la misma liga por bastante menos dinero.
Puntos fuertes
- El precio: es la forma más asequible de tener 128 GB para modelos.
- Es un PC x86 normal. Windows 11 o Linux, puertos de sobra, y sirve igual para trabajar, editar vídeo o jugar.
- Funciona con Ollama y LM Studio sin complicaciones, por Vulkan o ROCm. Si nunca has instalado Ollama, nuestro tutorial para instalar Ollama en Windows 11 sirve tal cual.
- Formato de estación de trabajo, con soporte para montarlo en un rack de 2U y agruparlo con otros.
Puntos débiles
- ROCm sigue por detrás de CUDA en compatibilidad con software de investigación y entrenamiento.
- Menos potencia de cálculo que el Spark para prompts largos y ajuste fino.
- El límite de 96 GB asignables a la gráfica en Windows.
MINISFORUM ya tiene una versión más reciente con el Ryzen AI Max+ Pro 495 y hasta 192 GB, que analizamos junto a su NAS en el artículo del MINISFORUM N5 y el MS-S1 con Ryzen AI Max+ Pro 495. Y el mismo chip 395 lo montan otros fabricantes, como GMKtec en su EVO-X2.
¿Y una RTX 5090 en un PC normal?
Es la pregunta que hay que hacerse antes de gastar en cualquiera de las tres. La RTX 5090 tiene 1.792 GB/s de ancho de banda, más que el M5 Ultra, y CUDA como el Spark. Con modelos que caben en sus 32 GB, es la más rápida de todas, tanto generando texto como procesando prompts.
Su techo es la memoria. Un modelo de 70B no cabe, y en cuanto hay que repartir capas con la RAM del sistema, la velocidad cae a una fracción. Por eso la pregunta correcta no es «cuál es más rápida», sino «qué modelo quiero ejecutar»:
- Modelos de hasta 30B: una RTX 5090 en un PC gana a todo.
- Modelos de 70B o MoE de más de 100B: hace falta una de estas cajas de 128 GB.
- Modelos de más de 300B: solo el M5 Ultra de 512 GB, o varias unidades en clúster.
Comparamos las gráficas dedicadas por VRAM y rendimiento en la guía de mejores GPU para IA local. Y NVIDIA prepara una alternativa intermedia, la RTX Spark, que adelantamos en el avance del superchip RTX Spark.
Cuál elegir según tu perfil
| Perfil | Recomendación | Por qué |
|---|---|---|
| Investigador o ingeniero de ML que entrena y hace ajuste fino | DGX Spark | CUDA nativo, mismo stack que la nube, potencia de cálculo en FP4 |
| Desarrollador que usa modelos grandes como asistente de código | Mac Studio M5 Max | Doble de ancho de banda que el Spark con los mismos 128 GB |
| Empresa que quiere modelos de 400B en local por privacidad | Mac Studio M5 Ultra (512 GB) | El único que los mueve en una sola caja |
| Aficionado que quiere probar modelos de 70B sin arruinarse | MINISFORUM MS-S1 MAX | 128 GB por el menor precio, y es un PC normal |
| Jugador que también quiere IA local | PC con RTX 5090 o 5070 Ti | Más rápido con modelos medianos y sirve para jugar |
Dónde comprar y qué vigilar
No ponemos precios de tienda porque en 2026, con la memoria disparada, cambian cada semana. Cada enlace lleva al precio del día. Tres avisos antes de comprar:
El DGX Spark: cuidado con la reventa
En Amazon.es el Spark aparece sobre todo a través de vendedores externos, muy por encima del precio oficial de NVIDIA. Compara antes con la tienda de NVIDIA y con los fabricantes que venden su versión del GB10 con el mismo chip, como el ASUS Ascent GX10, que lleva un SSD de 2 TB en lugar de 4 y por eso suele salir algo más barato.
- NVIDIA DGX Spark con 128 GB y SSD de 4 TB, ver precio actual en Amazon.
- ASUS Ascent GX10 con superchip GB10 y 128 GB, ver disponibilidad en Amazon.
El Mac Studio: la memoria no se amplía
La memoria unificada va soldada y se elige al comprar. Para IA, compra la mayor que puedas pagar: es lo único que no podrás cambiar después. En Amazon.es está disponible el M5 Max: Apple Mac Studio con chip M5 Max, ver precio actual en Amazon. Comprueba en la ficha la memoria de la configuración concreta antes de comprar.
El MS-S1 MAX y sus alternativas con el mismo chip
- MINISFORUM MS-S1 MAX con Ryzen AI Max+ 395 y 128 GB, ver precio actual en Amazon.
- GMKtec EVO-X2 con Ryzen AI Max+ 395 y 128 GB, ver disponibilidad en Amazon: mismo procesador, otro fabricante.
Fíjate en que la configuración sea la de 128 GB: hay versiones de 64 GB con el mismo nombre que se quedan cortas para modelos de 70B.
Si al final vas a por el PC con gráfica
La ASUS TUF Gaming RTX 5090 de 32 GB, ver precio actual en Amazon es la gráfica de consumo con más memoria. Y para cualquiera de estas máquinas, los modelos ocupan mucho: un SSD externo o interno rápido como el Samsung 990 EVO Plus de 2 TB, ver disponibilidad en Amazon evita quedarte sin espacio en la segunda semana. Si prefieres un portátil, tenemos la guía de mejores portátiles para IA local y desarrollo.
Preguntas frecuentes
¿Qué es más rápido para IA local, el DGX Spark o el Mac Studio M5 Ultra?
Generando texto, el Mac Studio M5 Ultra, porque su ancho de banda de memoria (1,2 TB/s) es más de cuatro veces el del Spark (273 GB/s). El Spark gana en entrenamiento, en ajuste fino y en el procesado de prompts largos gracias a CUDA y a sus Tensor Cores.
¿El MINISFORUM MS-S1 MAX es tan rápido como el DGX Spark?
En generación de texto, casi: su ancho de banda es de 256 GB/s frente a 273 GB/s. El Spark es claramente superior en potencia de cálculo, lo que se nota al procesar documentos largos y al entrenar.
¿Cuánta memoria necesito para ejecutar un modelo de 70B?
Unos 40 GB cuantizado a 4 bits, más margen para el contexto. Con 128 GB cabe con holgura; con una gráfica de 32 GB no cabe entero.
¿Por qué el DGX Spark cuesta más que al principio?
NVIDIA subió su precio oficial de 3.999 a 4.699 dólares en febrero de 2026 por el encarecimiento de la memoria LPDDR5X. En Amazon.es, además, lo venden sobre todo revendedores con sobreprecio.
¿Se puede usar Ollama en las tres máquinas?
Sí. Ollama funciona en DGX OS (Linux), en macOS con Apple Silicon y en Windows o Linux con el Ryzen AI Max+ 395.
¿Merece la pena el Mac Studio M5 Max frente al M5 Ultra para IA?
Si te bastan 128 GB, sí: el M5 Max tiene 614 GB/s, el doble que el Spark, por un precio de partida de 2.499 dólares frente a 5.499. El Ultra solo compensa si necesitas más de 128 GB o la máxima velocidad.
¿Una RTX 5090 es mejor opción que estas tres?
Con modelos que caben en sus 32 GB, sí: es la más rápida. Con modelos de 70B o mayores, no, porque tendría que repartir el modelo con la RAM y la velocidad cae mucho.
Este artículo contiene enlaces afiliados a Amazon con el tag arkaiacorp-21. Si compras a través de estos enlaces, Arkaia puede recibir una comisión sin coste adicional para ti. Nuestra valoración editorial es independiente y no varía según los ingresos por afiliación.
Comentarios
Inicia sesion para dejar un comentario
Acceder